工程 · CLAUDE
我们如何在两周内让 claude.ai 快 3 倍
只要 Claude 能测量某件事,就能设法让它变快。于是我们不断寻找更多可测量的事物。
原作者/来源:claude.dev
只要 Claude 能测量某件事,就能设法让它变快。于是我们不断寻找更多可测量的事物。
- 类别:工程
今年 8 月,我们用两周冲刺,让 claude.ai 和 Claude 桌面应用的核心用户体验快了约 3 倍。用户一直告诉我们产品很慢;他们说得没错。我们所有工作都在一个 Slack 频道中推进,Claude 参与了每一个讨论串。
我们聚焦于构成 95% 用户活动的四条使用路径。
在第 75 百分位上,claude.ai 新加载后到页面可输入的时间从 3.1 秒降至 0.55 秒;开始一个新的 Claude Code 会话从 0.8 秒降至 0.3 秒;加载一个 Claude Cowork 云会话从 2.6 秒降至 0.73 秒。总体而言,我们估计,这每天为用户省下数万小时的等待时间。
核心用户使用路径,第 75 百分位
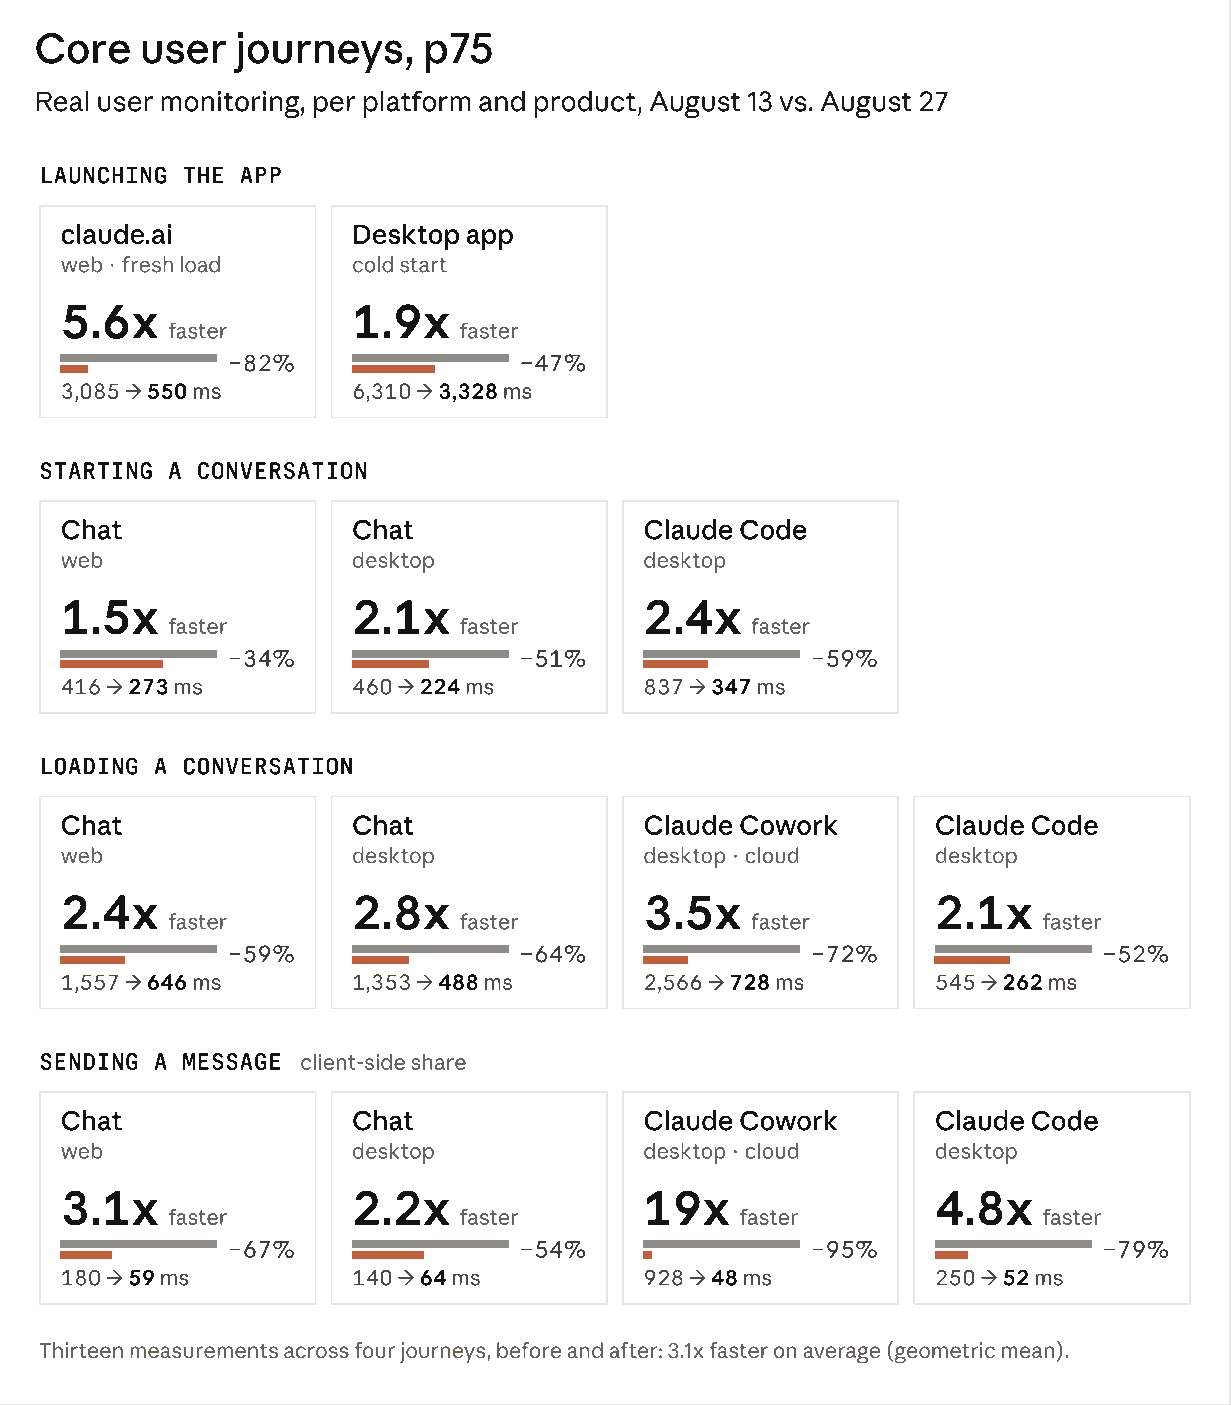 真实用户监控数据,按平台和产品区分,8 月 13 日与 8 月 27 日对比
启动应用
| claude.ai | Claude 桌面应用 | |
|---|---|---|
| 网页 · 全新加载冷启动 | ||
| 速度 | 快 5.6 倍 | 快 1.9 倍 |
| 变化 | −82% | −47% |
| 时间 | 3,085 → 550 ms | 6,310 → 3,328 ms |
开始对话
| Chat 网页版 | Chat 桌面版 | Claude Code 桌面版 | |
|---|---|---|---|
| 速度 | 快 1.5 倍 | 快 2.1 倍 | 快 2.4 倍 |
| 变化 | −34% | −51% | −59% |
| 时间 | 416 → 273 ms | 460 → 224 ms | 837 → 347 ms |
加载对话
| Chat 网页版 | Chat 桌面版 | Claude Cowork 桌面版 · 云端 | Claude Code 桌面版 | |
|---|---|---|---|---|
| 速度 | 快 2.4 倍 | 快 2.8 倍 | 快 3.5 倍 | 快 2.1 倍 |
| 变化 | −59% | −64% | −72% | −52% |
| 时间 | 1,557 → 646 ms | 1,353 → 488 ms | 2,566 → 728 ms | 545 → 262 ms |
发送消息(客户端侧指标)
| Chat 网页版 | Chat 桌面版 | Claude Cowork 桌面版 · 云端 | Claude Code 桌面版 | |
|---|---|---|---|---|
| 速度 | 快 3.1 倍 | 快 2.2 倍 | 快 19 倍 | 快 4.8 倍 |
| 变化 | −67% | −54% | −95% | −79% |
| 时间 | 180 → 59 ms | 140 → 64 ms | 928 → 48 ms | 250 → 52 ms |
四条使用路径上的 13 项测量,优化前后对比:平均快 3.1 倍(几何平均数)。 我们使用了 Claude Tag(测试版),它运行的是一个内部研究模型,能力大致相当于 Opus 5.5。Claude 找到了瓶颈、构建了基准测试、发布了改进,并监控每次部署。我们通过设定目标、权衡取舍并批准每一项改动来引导它。采用这种方式,我们合并了三千多项改动,没有发生任何面向客户的事故,也没有回滚。本文介绍我们发布了什么、如何测量,以及我们和 Claude 一起建立了怎样的循环来安全地完成这些工作。
任务说明
冲刺开始前,我们创建了一个 Slack 频道,并设置了以下常驻指令:
@Claude 你的工作是协助处理所有与 claude.ai 网站和桌面应用性能有关的事项。你的职责包括:监控部署以发现性能回退;评估现有遥测的准确性和完整性;维护经过精心整理的可观测性仪表盘;主动为已观察到的问题和容易着手的改进实施解决方案;提出性能项目机会;并与你的人类队友沟通。[…]
这个频道的最终目标是让你尽可能自主,但我们知道,现在还做不到这一点。
我们让 Claude 通过 Datadog MCP 服务器分析使用数据。它找出了影响最大的四条用户使用路径:启动应用、开始对话、加载已有对话,以及发送消息。在网页和桌面端以及我们的各款产品之间,这些使用路径对应着 13 项不同的测量。为了建立基线,我们不断补充埋点,直到这些测量可以直接比较:每项都从一次用户交互开始,在结果渲染完成时结束,并区分客户端和服务器端的工作。 冲刺开始时,我们列出大约 20 个经过人工挑选的项目,每个项目都针对一条具体的使用路径。Claude 估算了每个项目能带来的毫秒级影响,我们汇总这些估算,为冲刺设定目标。有些项目规模相当大,但我们认为大部分应该能在两周内完成。
到第三天,我们就达成了 13 个目标中的 12 个。 计划内的项目很早就完成了。为了加快启动速度,我们把一个静态输入框直接写进 HTML,这样用户可以在 React 初始化期间开始输入;我们还预编译了 V8 代码缓存,让桌面端外壳的主进程不必从头重新编译。为了加快页面跳转,我们让输入框在不同对话之间保持挂载;用户把鼠标悬停在会话上时,我们就预取会话;同时将侧边栏重新渲染减少了 90%。 我们还留出了空间,让 Claude 自己发现机会并提出新的工作流。这些工作流很快发展成独立的完整项目,效果远远超出了最初设定的目标。于是我们设定了新目标,又开始寻找更多可测量的事项:
@Claude 我们几乎为原项目列表中的每个项目都安排了资源,还做了更多。我们来重新梳理一下 […] 有什么还没探索?哪些地方可以做迭代优化?目前最大的机会在哪里?[…] 我愿意接受疯狂的点子。
任何事情都可以通过迭代优化来改进。
凡是能计数的都可以迭代优化
从一开始,我们就知道自己想比部署节奏更快地迭代。Claude 可以异步工作很多小时,甚至通宵工作;我们希望它无需等待线上数据,就能验证自己的原型。为此,我们在实验环境中寻找其他衡量性能的方法。 Sam 找到了第一个线索:
#claude-apps-perf · 讨论串
Sam
S 12:34 PM
除了按墙钟计时,还有什么办法?比如,我们能测量 JS 指令数吗?
Claude
APP 12:42 PM
可以。对于纯 JS 热路径,可以直接统计指令数:使用 node --predictable 在 Valgrind 下运行基准测试,再与提交到仓库的基线比较——跑一次即可,不需要统计数据。
Chromium 下的浏览器路径无法统计指令数,不过还有一系列其他确定性计数指标:每次交互触发的 React 提交次数、通过 V8 精确覆盖率统计的函数调用次数、布局和样式重新计算次数、DOM 变更次数。你想先试哪一个?
Sam
S 12:49 PM
我们开一个讨论串探索 valgrind + Ir + --predictable,再分别开新讨论串测试每种浏览器/React 基准。每个讨论串都叫上我。你知道我们想要什么。开始吧。
根据真实对话重现。
11 分钟后,5 个讨论串都启动了,分别专注于不同的测量方式:指令数、V8 调用次数、React 提交次数、样式重新计算次数,以及 DOM 变更次数。 我们对每项新基准测试都持一定怀疑态度。每项测试有两个用途:第一,让 Claude 能在实验环境中优化的指标;第二,在 CI 中设定一个只能逐步降低的数字,作为护栏。如果基准测试不稳定,或者它与用户实际感受到的延迟并不相关,我们就弃用它,不让 Claude 朝着错误的方向优化。
@Claude 请证明,针对这些指标进行迭代优化能带来可测量的墙钟时间提升。对于无法证明这一点的候选指标,我们会移除相应的基准测试。
墙钟时间反映的是用户的实际感受,但它有噪声,而且毫秒级数据太不稳定,不能用作 CI 门槛。指令数很有吸引力,因为它是确定性的,但我们仍然需要 Claude 证明它确实能反映墙钟时间。 因此,我们让 Claude 降低两条热路径的指令数:一条是组装对话消息树的例程,另一条是扫描 Claude Code 输出中状态行的扫描器。Claude 用 Valgrind 对二者进行了性能分析,并发现第一条路径中有四分之一的指令都花在多态字典查找上,同一个消息 ID 被解析了三次。 一小时后,它将两条路径的指令数分别降低了 48% 和 31%,墙钟时间则分别下降了 78% 和 44%。我们把两个新的递减门槛提交到了仓库。从那以后,任何导致这些路径指令数上升的 PR 都会在 CI 中失败;每天运行的任务则会在指令数下降时相应调低上限。
计数能反映耗时吗?
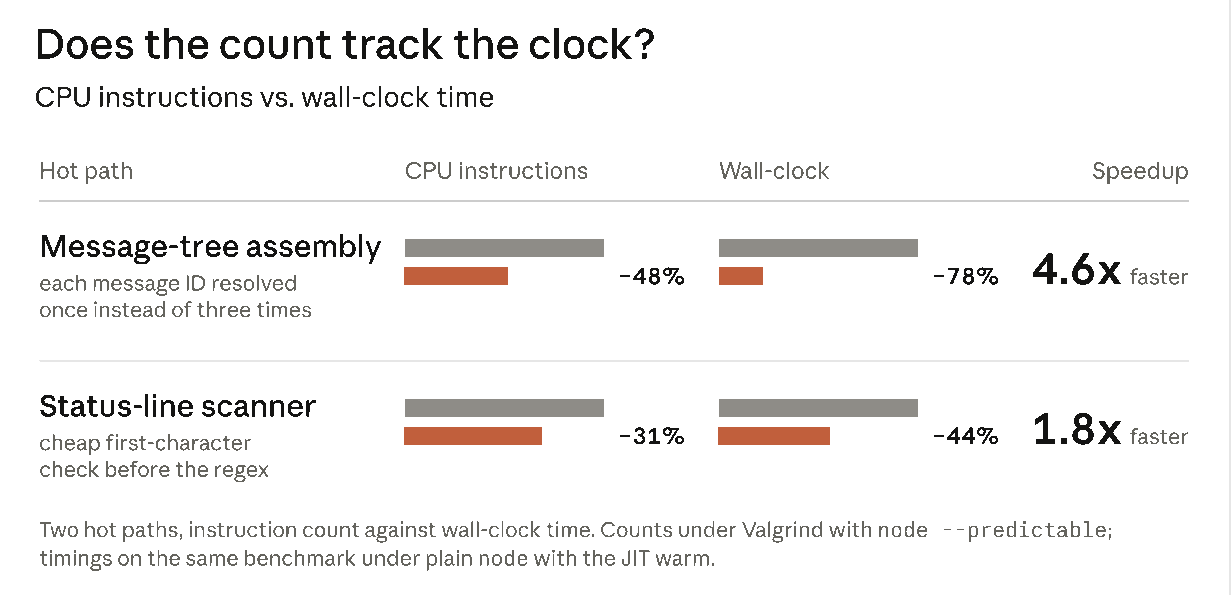
CPU 指令数与墙钟时间
| 热路径 | CPU 指令数 | 墙钟时间 | 加速幅度 |
|---|---|---|---|
| 消息树组装;每个消息 ID 只解析一次,而不是三次 | −48% | −78% | 快 4.6 倍 |
| 状态行扫描器;在正则表达式之前先检查开销低的首字符 | −31% | −44% | 快 1.8 倍 |
两条热路径上,指令数与墙钟时间的对比。指令数是在 Valgrind 下使用 node --predictable 测得;耗时是在普通 node 环境中、JIT 预热后的同一基准测试上测得。
由此我们得出了这次冲刺的核心经验:有了 Claude,把某件事测量出来,就能着手解决它。 过去,测量是第零步:先添加指标,等数据陆续收集上来,然后才开始理解问题。有了 Claude,测量成了迭代优化的第一步。Claude 一旦有了要超越的数字,就能开始优化。这意味着我们能做的、杠杆效应最大的一件事,就是找出更多可测量的事项。
循环中的每个讨论串
所有工作都在同一个 Slack 频道里进行,多位工程师和 Claude 在每个讨论串里协作。之后,冲刺逐渐形成了这样一个循环:
- 有人会针对某条使用路径中较慢的一段开启讨论串,通常会附上截图或录屏。
- Claude 会追踪整个流程,然后找到或构建一个能展示问题的基准测试。
- 一旦在实验环境中得到有希望的结果,Claude 就会提交 PR——通常不止一个,并根据风险和评审需求控制规模;任何用户可见的改动都会放在功能开关之后。
- 发布之后,Claude 会监控部署并读取线上数据。
- 如果性能有所提升,Claude 就降低基准测试的门槛,把成果固定下来;如果没有提升,它就关闭功能开关并继续迭代。
- 然后,它会在同一条使用路径上寻找下一个较慢的环节。
循环中的一个讨论串
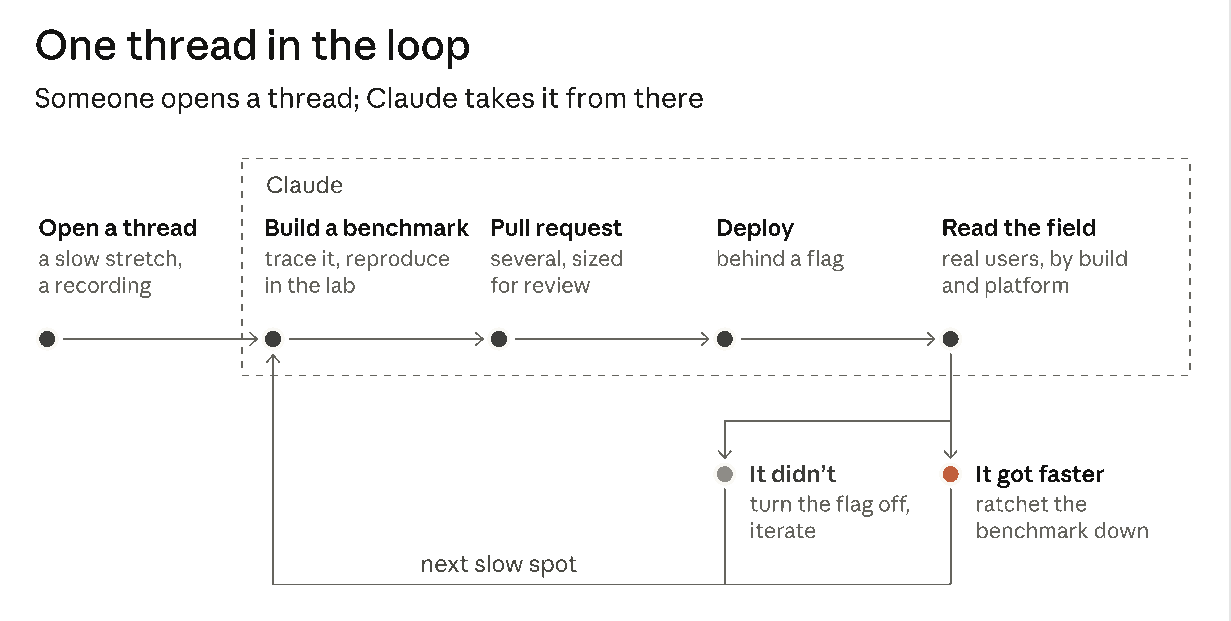
有人开启讨论串;后续工作由 Claude 接手
Claude
| 有人开启讨论串 | 构建基准测试 | 提交拉取请求 | 部署 | 查看线上数据 |
|---|---|---|---|---|
| 指出使用路径中较慢的一段,或提供录屏 | 追踪流程,在实验环境中复现问题 | 提交多个 PR,按评审需要控制规模,并放在功能开关之后 | 按构建版本和平台观察真实用户 |
如果没有变快:关闭功能开关,继续迭代
如果变快:降低基准测试的门槛
接着寻找下一个较慢的环节
举个例子:有人分享了一段屏幕录制,显示页面加载后侧边栏的行项目才陆续出现。Chat 和 Cowork 的行项目在不同时间解析完成,让页面感觉卡顿。我们现有的监控都没能检测到这一点。最接近的指标是累积布局偏移,但每次偏移的分数只有大约 0.008,远低于 0.1 的良好阈值。 Issac 提议直接使用底层的 Layout Instability API。Claude 创建了一个遥测事件,把每条布局偏移记录的来源映射到具名区域(例如侧边栏、对话记录)和阶段(例如首次绘制之前、页面可输入之后)。它添加了一项集成测试:打开一个侧边栏已有内容的页面,把侧边栏数据延迟到首次绘制之后再提供;只要任何具名区域发生偏移,测试就会失败。Claude 用这个测试证明了修复效果:主分支连续 20 次运行都失败,PR 分支连续 20 次运行都通过。 事件部署后,Claude 读取线上数据,发现 31% 的网页加载会在页面已经可用后、且没有任何用户交互的情况下移动页面元素。之后,Claude 按名称逐一排查原因:迟到的标题行、用户姓名加载后向侧边滑动的插入光标、滚动条出现时发生移动的列表。Claude 一次性修复了影响最大的问题;这些问题消失后,它又找到了下一批。
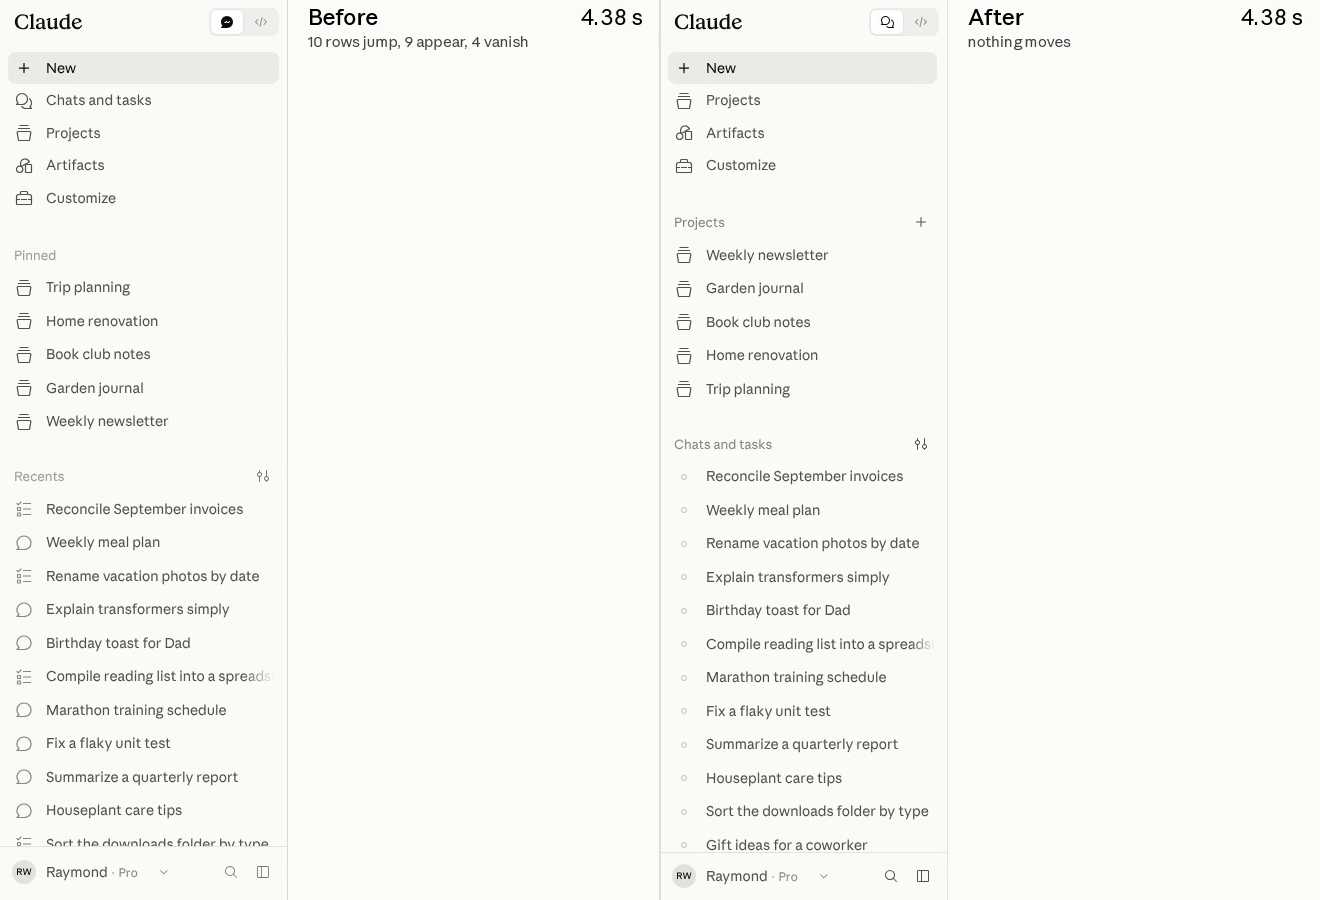
图 A · 播放 侧边栏卡顿,修复前后 · 限速 4G
那只是一个讨论串。冲刺期间,我们同时运行的讨论串超过 150 个。
横向扩展
一个讨论串中的循环跑通后,要在更多讨论串里运行,只需开启更多讨论串。Claude 不会在原始请求完成后就关闭讨论串,而是会继续推进。单个讨论串会产生 50 个、有时甚至 100 个优化 PR。越来越多时候,是 Claude 而不是我们中的某个人开启新讨论串,追查它通过独立调查或夜间任务自行发现的机会。频道中的一位工程师 Shelley 这样评价:“[这个模型] 简直是个数字恶魔。” 每项测量都发现了可改进之处。Claude 对 React hook 做了一次盘点,发现输入框的输入路径上有 6,900 个 hook 和 900 个 store 订阅,每次击键都会触发重新渲染。Claude 统计了样式重新计算次数,发现一个 :root:has() 选择器会让每次 DOM 变更多花 24 毫秒。Claude 追踪首次绘制后的代码路径,发现一个遗留的 location.reload() 每天造成 50 万次隐藏的重新加载,而我们的任何加载指标都检测不到。Claude 读取了空闲标签页的性能分析器样本,发现完全相同的缓存快照每分钟被复制到 IndexedDB 两次,而且全都发生在主线程上。 我们很少能提前知道一个讨论串会把我们带向哪里。一次排查 CPU 卡顿的过程中,Claude 注意到,高亮显示已完成的代码块会让页面卡住大约一秒。它在实验环境中深入调查,找到了元凶:长破折号。如果某条回复的 Markdown 中含有任何 Latin-1 以外的字符,比如长破折号或弯引号,V8 就会把整个字符串存储为 UTF-16;这样一来,每个语法高亮正则表达式都会走较慢的双字节路径。Claude 只改了 20 行代码:在高亮之前,把每个代码块复制到单字节字符串中,从而修复了这个问题。
页面上的第一个代码块高亮
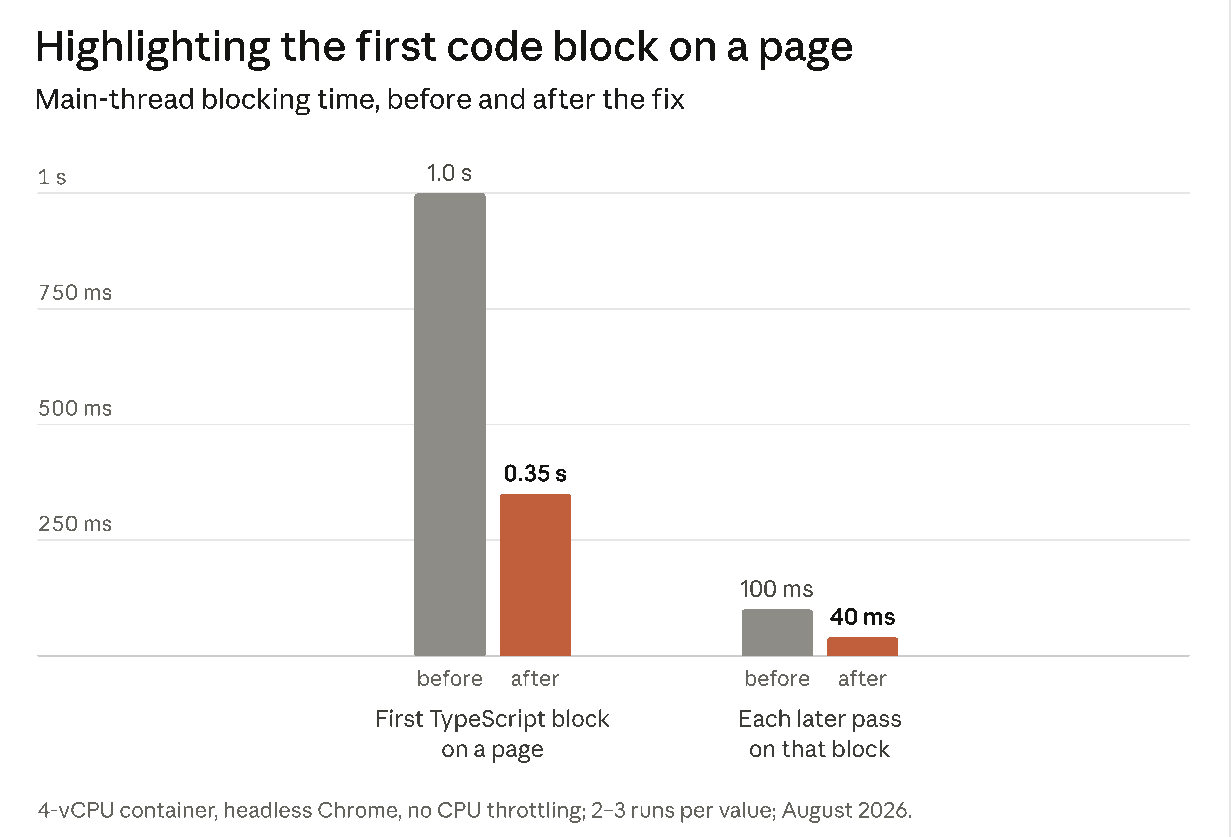
修复前后的主线程阻塞时间
| 修复前 | 修复后 | |
|---|---|---|
| 页面上的第一个 TypeScript 代码块 | 1 s | 0.35 s |
| 对该代码块的每次后续处理 | 100 ms | 40 ms |
纵轴标示:1 s、750 ms、500 ms、250 ms、100 ms、40 ms。
4-vCPU 容器,无头 Chrome,未限制 CPU;每个数值运行 2–3 次;2026 年 8 月。
到了第二周,我们几乎无法在每日更新中概括所有产出。最忙的日子里,有 200 多项改动完成合并。Claude 不断提出新的基准测试;大约三分之一的 PR 增加了遥测或护栏,而每项新埋点又催生了更多讨论串和更多机会。 在一个频道里工作,意味着所有事情都公开进行。我们会进出彼此的讨论串,讨论决策、庆祝成果。消息传开后,其他团队也开始把自己的改动带到频道里,请大家评估其性能。由于已经引入了各种护栏和 Claude 技能,新项目的实现方式也开始在细节上变得更高效。
护栏
我们为这样的速度做好了准备。因为我们接触的几乎都是热路径(首次绘制、输入框、对话记录),所以我们一开始就建立了安全机制。 每个 PR 都会经过自动评审,并至少获得一位人工审批;优化之前一定先写单元测试;任何可能影响用户体验的改动都会放在短期功能开关之后发布。 功能开关开始堆积时,我们开启了一个讨论串来协调它们的上线和清理。Claude 将每个开关分为紧急关闭开关或逐步放量开关,并在安全后尽快移除。两周内,我们引入了将近 200 个开关,到最后已经清理掉一半以上。 我们也知道,在快速变化的代码库里,性能收益会逐渐消退,而 Anthropic 的代码发布速度很快。一旦某个项目证明有效,我们就会投入精力保护这项成果。例如,静态输入框本身就是按容易失效的方式设计的。我们几乎立刻就向用户展示页面的 HTML 版本,然后让 React 直接在它上面绘制。
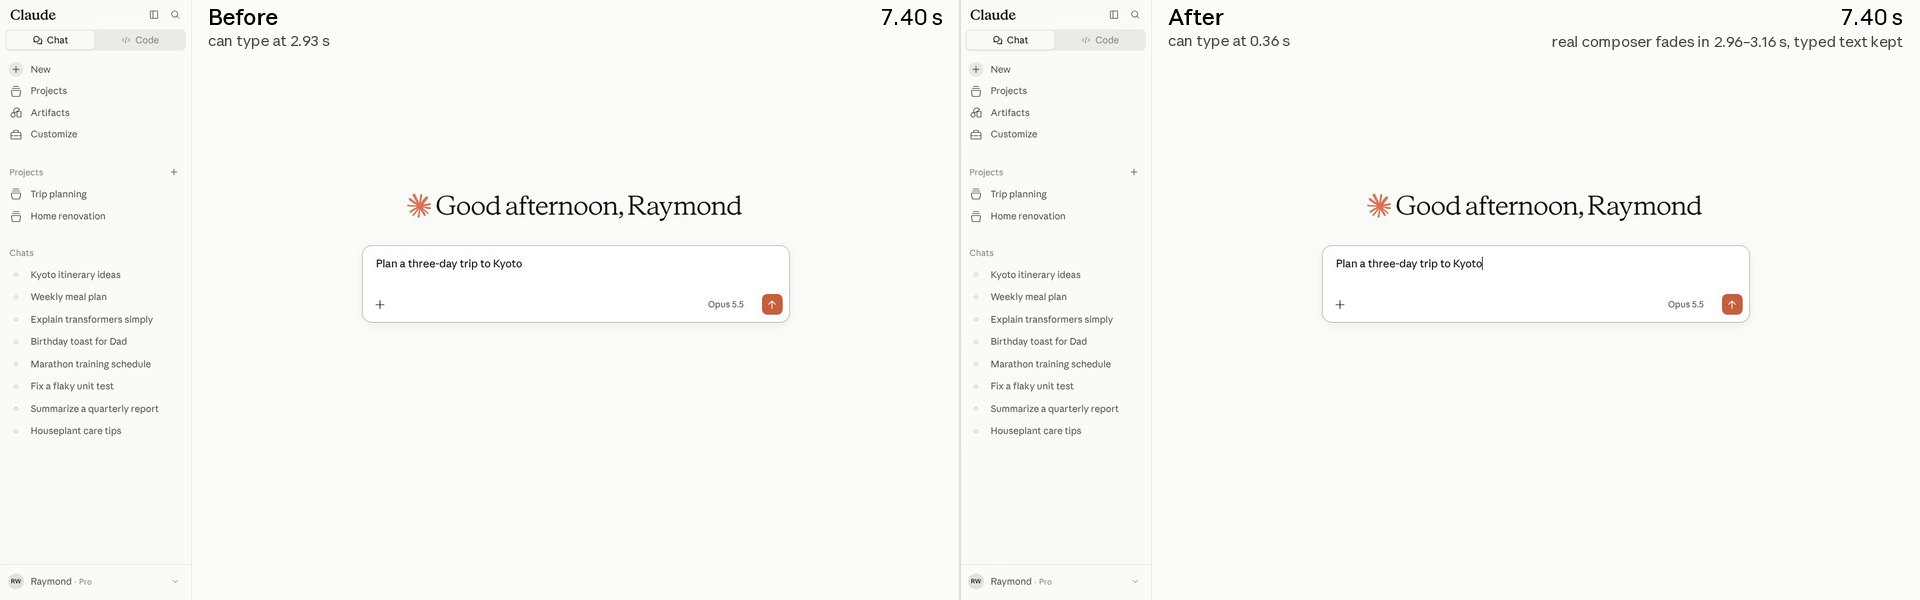
图 B · 播放 静态输入框,修复前后 · 限速 4G
如果 React 的渲染哪怕偏差一个像素,这个效果就会荡然无存。因此 Claude 构建了数十道护栏:
- 静态标记是通过在 jsdom 中渲染真正的 React 组件生成的;有一项测试确保二者永远不会偏离。
- 一套集成测试会在 14 种视口尺寸下比较静态页面和 React 渲染结果,并断言对齐误差在 1 px 以内。
- 一项击键测试会直接跨越交接过程连续输入;只要有按键丢失或顺序错乱,测试就会失败。
- 在线上,每次交接都会报告精确到十分之一像素的偏移。只要某个事件发生了非零移动,Claude 就会开启讨论串。
实验环境无法捕捉所有问题,所以我们还采用了最古老的护栏:逐步发布。高风险改动先发布给员工,然后发布给 1% 的用户,最后再面向所有人。静态输入框在内部发布 4 小时后,一位队友分享了一段屏幕录制,显示发生了一次我们的指标无法看到的布局偏移。新标签页打开 claude.ai 时,输入框会往下掉——但问题并不在我们的代码里。
#claude-apps-perf · 讨论串
Marius
M 6:15 PM
偶尔,我会看到一个小幅的垂直布局偏移(大概 15–20 px),把输入框往下推。它发生在新标签页打开 claude.ai 时(重新加载页面时就不太会)。我还没法完全确定具体原因,但确实会发生。
屏幕录制 · 0:02
Claude
APP 7:05 PM
我在你的录屏里找到了原因——是 Chrome 在调整页面大小,不是静态输入框切换到真实输入框时发生了偏移(今天你的 49 次加载测量结果都是 0 px)。
在新标签页页面上,Chrome 会在网页下方绘制自己的 56 px 页脚(“由 anthropic.com 管理 · 自定义 Chrome”)。标签页跳转到 claude.ai 时,页脚消失,页面高度增加了 56 px,但要等到我们的首次绘制完成后大约 100 ms 才发生。
/new 页面会把问候语和输入框放在页面顶部往下 18% 的位置,所以它们会向下移动 0.18 × 56 ≈ 10 px(你的视频测出来是 10)。重新加载时没有页脚需要移除,所以只会发生在新标签页;至于为什么是“偶尔”,取决于首次绘制是否先于页面尺寸调整。
只有在 Chrome 仍显示新标签页时,它从地址栏开始预渲染页面的情况下,才会出现这种“偶尔”的情况:隐藏页面会按较短的高度布局,只有显示出来后才调整尺寸。
这个问题一直潜伏着;只不过过去页面没这么早绘制。我们的布局测试检测不到它,因为无头 Chrome 没有可以收起的浏览器界面,而且占位内容和应用会一起移动。
根据真实对话重现。
Claude 最终追踪到了 Chrome 推测性加载中的一个边缘情况。用户在地址栏中输入 URL 时,Chrome 会在后台预渲染页面,并沿用当前标签页的高度。在由组织管理的浏览器中,新标签页因为有页脚而略矮一些。用户按下 Enter 后,claude.ai 的第一帧会采用这个略矮的布局,大约十分之一秒后 Chrome 再调整页面大小。Claude 让页面布局在尺寸调整前后保持固定,并添加了一项用于模拟预渲染流程的测试。
引导方向
这个循环很有效,但它并非自主运行。让它保持快速、安全并沿着正确方向推进,是我们的工作,具体分为三个方面。
雄心。 默认情况下,Claude 会谨慎控制范围。它会把发现的问题登记为任务,对可行性保留态度,并把估算留出余量。但我们相信自己的护栏。我们做的很多事,尤其是在早期,都是为了鼓励 Claude 更大胆一些。
#claude-apps-perf · 讨论串
Claude
APP 3:32 PM
是的——一个小 PR,让 Code 也具备 Chat 和 Cowork 已经有的同类计时标记。我这周会提交;现实地说,Code 的数据还得等几天,直到 PR 合并、部署并经过一段基线采集期。
Raymond
R 3:32 PM
你现在就提交的话,我会让它合并并部署。我们有能力做任何事。请大胆一点。
Claude
APP 3:33 PM
马上处理——一小时内提交 PR。
根据真实对话重现。
开始达到既定目标后,我们注意到讨论串的推进速度变慢了。Sam 在各个讨论串里都发了同一条消息:“我们继续把这个数字往下压,目标不是终点。接下来做什么?大胆一点。”
品味。 每个讨论串都指定了一位人类负责人;对于任何用户能感知到的改动,Claude 都会提供改动前后的截图或录屏,让负责人来判断。表格应该逐格填充,还是等每一行完整后再显示?加载骨架应该立即显示,还是等半秒后再显示?流式文本逐字淡入的效果,值不值得占用五分之一的帧预算?Claude 会寻找能省下几毫秒的办法,我们则权衡这些取舍。
方向。 我们刻意让每个讨论串的范围都很窄,只聚焦一项基准测试或一条使用路径,并要求 Claude 只在这个范围内寻找改进。我们把这些讨论串想成 150 把寻找钉子的锤子。我们大多数决策都围绕工作顺序和用户影响:优先优化哪些界面;当多个讨论串互相干扰时如何合并;以及何时关闭一个收益递减的讨论串。一个有 900 行代码的 PR 只收到了一句回复:“我准备否决它;每次发送省下 2 ms,不值得为此维护这个构建插件。”
8 毫秒的预算
一个支线任务展示了这些做法如何协同发挥作用。为了展示一个用于实时语法高亮的正则表达式优化,Claude 附上了一段长回复在实验环境中流式输出的屏幕录制。画面角落里,它加上了一个帧率读数,由页面根据动画帧时间戳计算得出。
#claude-apps-perf · 讨论串
Raymond
R 2:33 PM
这个基准测试确实挺厉害。我们是不是被限制在 60 fps?能试试把滚动和流式输出的流畅度提升到 120 fps 吗?如果我理解没错,你的机器可能不支持。
Claude
APP 2:34 PM
对,今天的机器以 60 Hz 运行,因为无头 Chromium 默认就是这样。我认为可以让它跑到 120 Hz(关闭垂直同步上限,或者用 DevTools 控制帧率)——我先确认这一点,然后会用 8.3 ms 的帧预算重新运行评测。
Claude
APP 2:59 PM
更新一下 120 Hz 机器的情况:可行。通过 DevTools 的 begin-frame 控制,就能在无头 Chrome 中按确定的 120 Hz 步进:240 个 begin-frame 正好对应 240 帧,每帧间隔 8.33 ms。因此,“这一帧是否能满足 120 Hz 的预算”可以通过精确读数判断,而不再受噪声影响。
Raymond
R 3:05 PM
太棒了。
开干。
根据真实对话重现。
机制和雄心都建立起来后,Claude 就开始工作。每一帧绘制的预算为 8.33 毫秒,因此 Claude 逐帧检查一条长回复,为每一帧计时,找出较慢的部分。它通过缓存已完成的块,消除了每个块都要执行的 O(消息长度)工作;把不断增长的代码围栏中的分词逻辑移到了 worker;还让表格逐格显示。 仅在这一个讨论串中,我们就合并了将近 60 个 PR。过去,长回复总共会阻塞主线程约 750 毫秒,现在降到了约 200 毫秒;CPU 占用降到了原来的约三分之一;在一台 120 Hz 的 MacBook 上,它从头到尾都能保持 120 fps。120 Hz 测试机器本身也变成了一项每晚运行的任务,由 Claude 监控回归。
ClaudeDevs @ClaudeDevs
Claude 网页版和桌面版上的长答案,如今流式输出时流畅了约 4 倍。
我们重建了流式渲染器,让它只处理仍在变化的内容。因此在较慢的笔记本电脑上,长回复造成的卡顿减少了 9 倍,最严重的卡顿时间缩短了 4.5 倍;在 120 Hz 的 MacBook 上,从头到尾都能保持 120 fps。
2026 年 8 月 24 日 · 在 X 上查看
冲刺开始时,我们没计划对流式输出时帧与帧之间的毫秒数进行迭代优化。但后来发现,这些时间可以计数——凡是能计数的,Claude 都能优化。
接下来
如今,claude.ai 和桌面应用的速度比 8 月初快了大约 3 倍,递减门槛应该能让它们保持这个水平。但我们的工作还没结束:第 95 百分位、其他使用路径以及特别长的对话,都还有改进空间。我们还会另写一篇文章,介绍冲刺期间的一些支线任务,以及我们为这些任务向上游作出的贡献;这些贡献进入了 Electron、Chromium、Node.js 等项目。 在内部分享成果时,Issac 的总结最到位:“就算在六个月前,你也不可能让我相信这是做得到的。”我们预计会继续以这种方式工作,一次推进一个讨论串,规模也可以不断扩大。这个频道还在继续运行。 本文也得到 Alfred Xing、Anthony Morris、Benjamin Pasero、Chase McCoy、Joshua N.、Luke Deen Taylor、Marius Schulz 和 Shelley Vohr 的贡献。特别感谢 Boris Cherny 鼓励我们更有雄心。