工程 · CLAUDE
使用 Claude Code:分配你的 effort
> effort 究竟是什么、在 Claude Code 中何时使用哪个档位——基于我对三个构建任务的测试,以及对 Opus 5.5 和 Fable 5.1 在 Terminal-Bench 3.0 上的深入研究。
原作者/来源:claude.dev
effort 究竟是什么、在 Claude Code 中何时使用哪个档位——基于我对三个构建任务的测试,以及对 Opus 5.5 和 Fable 5.1 在 Terminal-Bench 3.0 上的深入研究。
我们最新 Claude 模型最出色的一点,是它们能在不破坏 Claude Code 中提示缓存的情况下响应 effort;但我也收到了很多用户关于这一点的问题。effort 究竟是什么?什么时候该用哪种 effort 档位?为什么需要 effort?为了回答这些问题,我决定深入研究评测,并针对日常工作中不同 effort 档位的效果做自己的测试。
总体来说,我发现 effort 是调节 Claude 做多少验证和边界情况测试、以及运用多少自身判断力的好方法。在硬件、代码审查和安全等更需要验证和边界情况测试的领域,额外的 effort 能带来更好的结果。
对于常规软件工程,我采用这样的循环:先让模型采访我,然后用 low effort 实现,审查它构建的内容,最后用 high effort 进行验证。
什么是 effort?
总体来说,effort 让模型大致了解你希望它在任务上投入多少计算资源。这在一定程度上与你对任务难度的判断有关。
可以这样想:如果有人让你连续花 12 个小时做某件事,你可能会认为他们就是希望你完成它,于是尽最大努力去做。如果有人让你在 1 个小时内做同一件事,你会尽量交付符合要求的最佳版本,然后预期之后还会继续迭代。
或者,你也可能会提出异议,说这项任务至少需要 3 个小时,然后花 3 个小时把它交付出来。
你也应该用同样的方式理解 effort。Claude 总会尽力合理地完成你的任务,但更高的 effort 会让 Claude 更自主地采取行动、做出判断并进行验证。
effort 曲线
Fable 5.1 和 Opus 5.5 的 effort 曲线是迄今为止最好的:在每个档位上,基准分数和消耗的 token 数都会上升。
Terminal-Bench 3.0
PNG
按 effort 设置划分的通过率随 token 消耗的变化
- 纵轴:通过的尝试占比(20%、30%、40%、50%、60%、70%)。横轴:每次尝试的 token 中位数,对数刻度(50k、100k、200k、300k)。
- 图中模型系列:Opus 5.5、Fable 5.1、Opus 5 和 Fable 5。图中点位旁的档位标注包括:low、medium、high、xhigh、max。
- 图中注释:Opus 5.5 的 high 档与 Fable 5.1 的 max 档得分相同,前者只使用后者一半的 token。
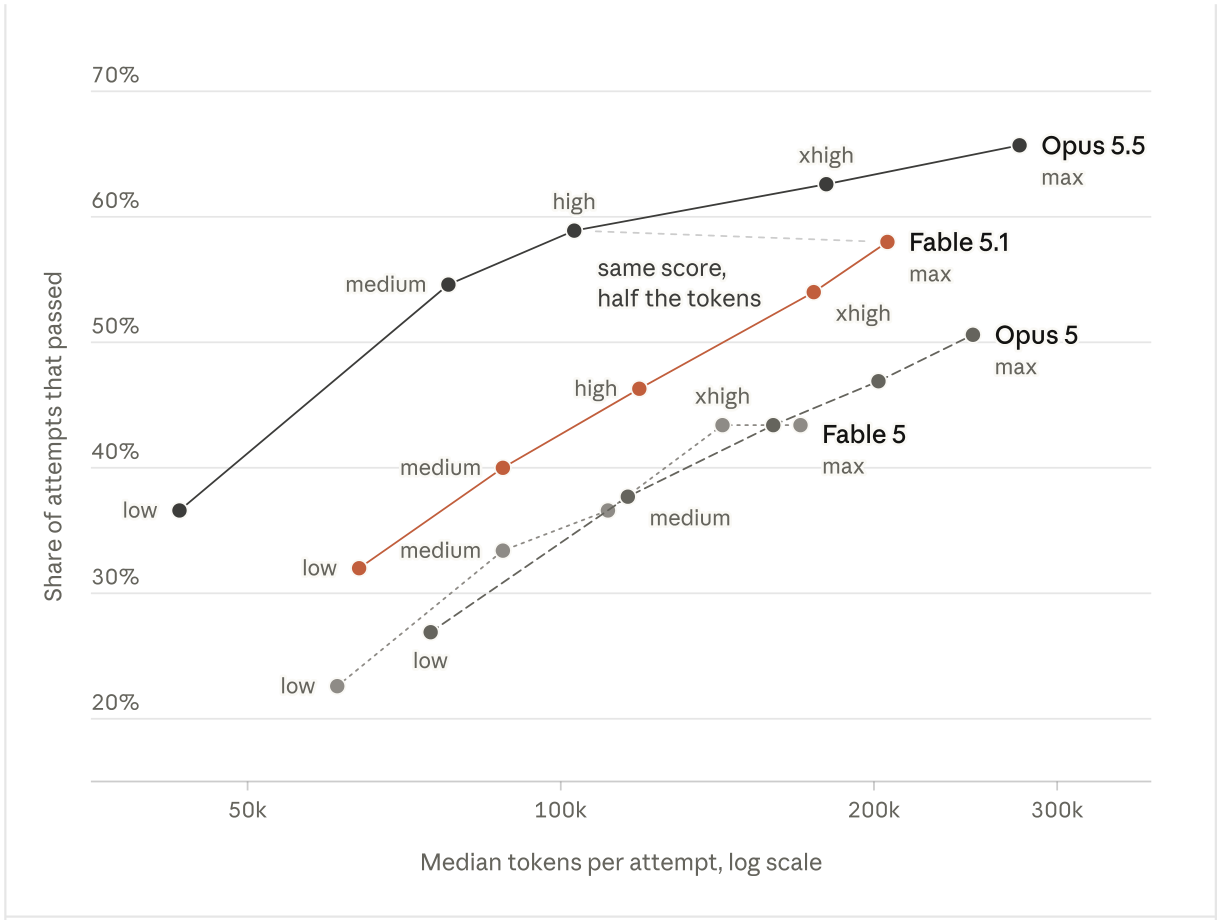
图 A Terminal-Bench 3.0:每个模型都使用相同的 70 项任务(排除 4 项 GPU 任务)。Opus 5.5 的运行时间大约晚了三周,响应上限设为 128k token,且无法访问 GitHub 或 PyPI;Opus 5 的 max 结果来自其 effort-120 运行。
但这在实践中意味着什么?为了评估这一点,我尝试在不同 effort 档位下完成多项任务,并仔细研究了基准测试结果。
使用不同 effort 构建
理解模型如何工作的最佳方式是做实验。我在 Opus 5.5 上用几个不同的 effort 档位尝试完成相同任务,以了解它会做哪些工作。我尝试了各种各样的任务,但这里用几个玩具示例来说明。
需求不明确的构建任务
如果我让 Claude“构建一个个人健身和锻炼追踪应用”,effort 会显著改变应用的完善程度,也会让 Claude 在过程中做出更多选择。
在 low effort 下,健身应用只是一个日志和一张简单的图表。effort 档位更高时,应用会更复杂,也包含更多细节。到了 max effort,还会有一张热力图。
LOW(1.5 分钟) MEDIUM(4 分钟) HIGH(11 分钟) MAX(67 分钟)
如果我想先拿到一个简单的基础版本,再继续迭代,low effort 就能完成。如果我想让 Claude 一次性给出它的最佳成果,就会用 max effort。
规格较少的设计任务
如果任务已经有相当明确的规格,但我还想和 Claude 一起探索,会怎样?举例来说,我让它重新设计 Claude Code 中的 /config 菜单。每次尝试的总体思路都差不多:使用子菜单并改进搜索。
在 low effort 下(用时 1 分钟),我得到一个交互式草图,表达出了这个想法,但看起来不太像 Claude Code。
在 max effort 下(用时 28 分钟),我得到了一份非常像 Claude Code 的模型稿,还附带了针对不同流程的一系列演示。
如果我的目标是迭代并给出反馈,low effort 会快得多。但 max effort 一开始就能给我更精致的成果。对于这个特定任务,我认为先用 low effort 了解 Claude 的构想更合适。
LOW MEDIUM HIGH MAX
规格非常明确的构建任务
如果我给 Claude 很多细节呢?我尝试让 Claude 深入采访我,了解健身应用的需求,然后把这份规格交给不同模型,以不同 effort 档位实现。
我发现,在给定这份规格后,模型的表现相似得多。我得到的设计看起来相当相似,实现方式也类似,但细节有所不同;在 max effort 下,Claude 花了一些时间简化其中几处细节。
LOW(16 分钟) MEDIUM(22 分钟) HIGH(33 分钟) MAX(79 分钟)
PREVIOUS NEXT PAUSE
要点
对于常规软件工程工作,尤其是开发新功能,effort 档位在很大程度上取决于我希望自己参与到流程中的程度。low effort 让 Claude 快速给出一个起点;更高的 effort 档位能完成更多工作,但 Claude 也会替我做出更多假设。
我在功能开发中一直使用的一个特别有效的循环是:
- 给 Claude 一份规格,并让它针对我遗漏的细节采访我。
- 用 low effort 实现。
- 检查它是否正确理解了要点;如有需要,用 low effort 继续迭代。
- 用 high effort 验证和测试。
effort 档位如何影响困难任务的输出
不过,这些显然都是玩具示例,Claude 能够很好地完成它们。那么,当差别在于 Claude 能否完成任务时,情况又如何?
要找到这些难题,你得去看基准测试,所以我深入研究了一个我喜欢的基准:Terminal-Bench 3.0,这是一个由社区提供任务的基准。
Terminal-Bench 3.0 的题目大致可分为安全、硬件、机器学习、科学、软件、运维和媒体等类别。你可以在这里查看所有题目:https://github.com/harbor-framework/terminal-bench/releases/tag/v3.0.0。这些题目来自社区,因此任何人都可以贡献。
阅读这些题目,能让你了解这些模型要面对什么类型的问题。我发现,很多任务的范围和雄心都让我感到意外。它们比我会遇到的普通任务复杂得多。
例如,其中有些任务包括:
- 硬件(
retro-console-soc):用 Verilog 构建一台 8 位游戏主机,让它适配一块小型 FPGA 并能运行测试 ROM。 - 科学(
takens-embedding-lean):在 Lean 4 中形式化证明 Takens 嵌入定理。 - 机器学习(
mp-checkpoint-consolidation):将一个混合专家检查点的 16 个分片合并到一个文件中,并复现参考 logits。 - 运维(
intrastat-meldung):端到端完成一家公司的月末欧盟贸易统计申报。 - 媒体(
layout-config-recreation):将一张海报图像重建为可编辑的版式文件。
面对许多边界情况时,更高的 effort 会有帮助
我阅读 Terminal-Bench 3.0 结果后得到的主要结论是:对于存在许多隐蔽边界情况的任务,更高的 effort 最有帮助。
一个很典型的例子是 html-js-filter,这是 Terminal-Bench 3.0 的一项任务,要求构建一个 HTML 清理器,移除所有将 JavaScript 偷渡进网页的方法。Fable 5.1 的成绩从 low 档的 1/5 提高到了 xhigh 档的 5/5。¹
low effort 下,一次典型尝试大约需要 2 分钟。每次尝试基本上都用一轮写出过滤器,然后只用一个手写页面进行测试。
high effort 的运行大约需要 33 分钟。在我追踪的一次运行中,它先对自己的初稿进行了对抗性审查,然后阅读已安装解析器的源代码以检查是否有 bug,运行了许多干净测试用例,确认输入和输出相同,接着运行标准 XSS 测试套件,最后编写了一个随机文档模糊测试器。
对于 HTML 清理器这种边界情况繁多的任务,额外投入的 effort 非常值得。对于生产要求很高的复杂任务,例如性能优化或安全审查,花更多 token 来做到周全也很合理。
但并不是每项任务都需要这种 effort 档位。
下图展示了 Terminal-Bench 3.0 的所有结果,以及不同模型和 effort 档位下的失败方式。总体来说,提高 effort 往往能减少因遗漏边界情况而导致的失败(紫色方块),但无法解决模型采用了错误方法的情况(蓝色方块)。
模型:Fable 5.1、Opus 5、Fable 5;effort:LOW、MEDIUM、XHIGH、MAX。
| 结果 / 失败类型 | Fable 5.1:low | Fable 5.1:max |
|---|---|---|
| 尝试次数 | 370 | 370 |
| 每次尝试的 token 中位数 | 73k | 222k |
| 通过 | 140 | 214 |
| 做出了错误判断 | 133 | 107 |
| 误读一项需求 | 45 | 26 |
| 漏掉一个情况 | 59 | 24 |
| 修复错误或不完整 | 31 | 10 |
| “在我的机器上能用” | 2 | 1 |
| 搞错领域规则 | 32 | 24 |
| 对示例过拟合 | 7 | 3 |
| 选择了错误的解读 | 25 | 47 |
| 接近正确,但并不完全正确 | 10 | 6 |
| 测试未能发现的 bug | 40 | 14 |
| 其他失败 | 38 | 25 |
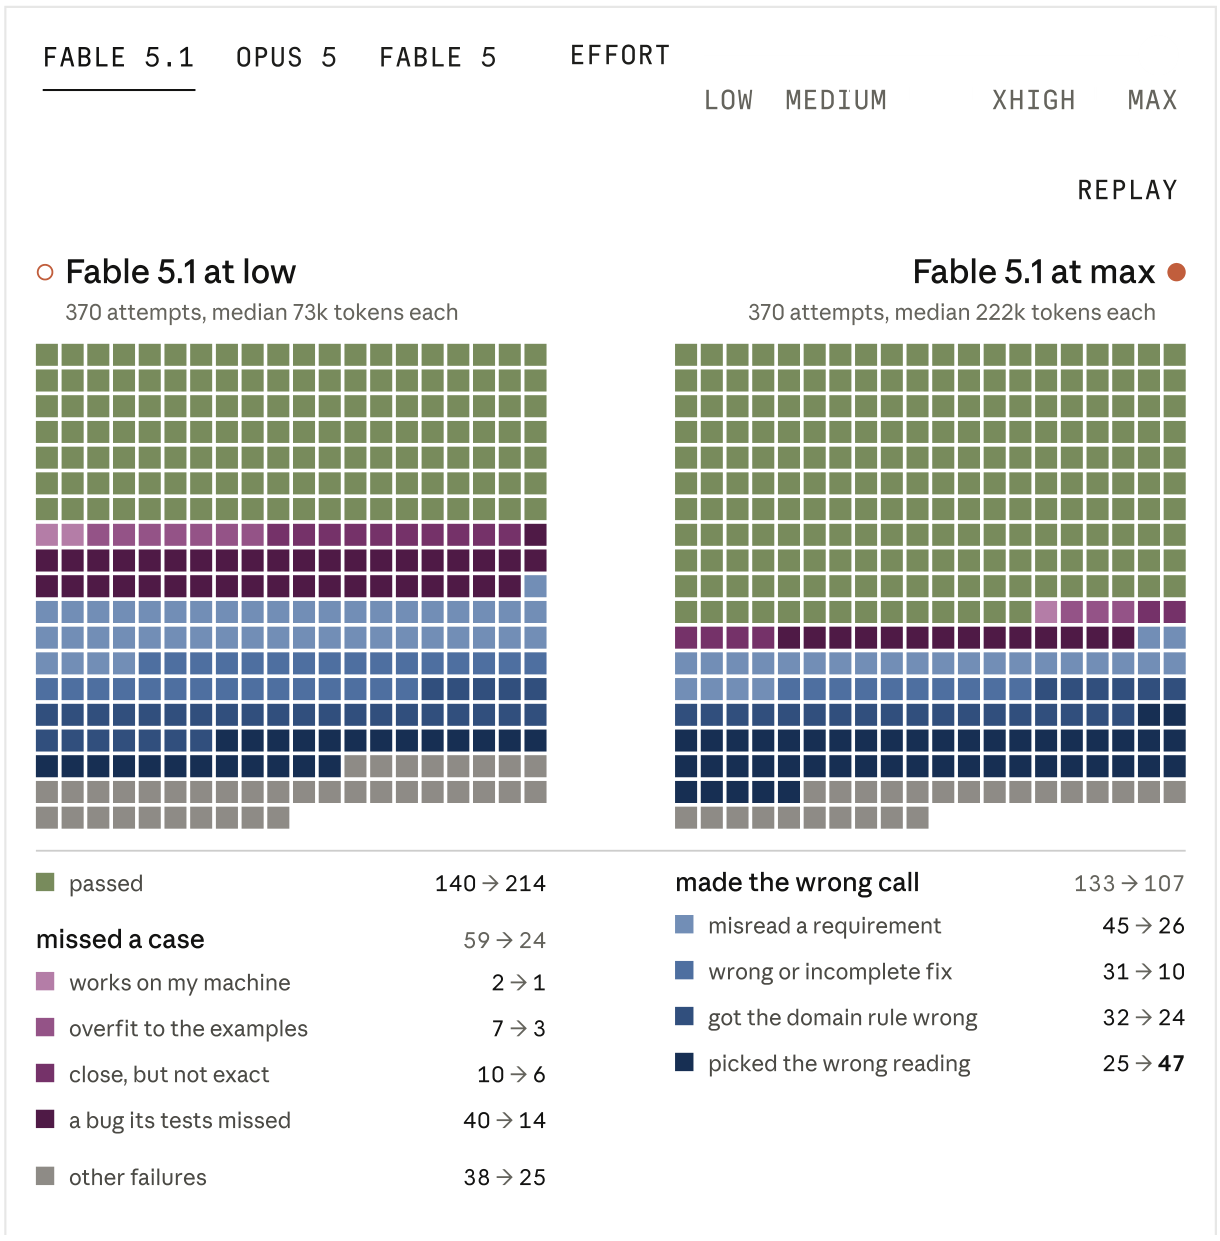
图 B 每个方块代表一次尝试。失败类型由模型裁判判定,属于近似分类。
effort 有帮助的问题领域
我在 Terminal-Bench 3.0 上评估这些模型时,最有意思的发现之一是:有些问题领域比其他领域更能从 effort 中获益。下图展示了细分结果:
图例: Fable 5.1、Opus 5、Fable 5;空心点表示 low effort,实心点表示 top effort;回放。
| 领域 | 通过率变化 | 任务数 |
|---|---|---|
| 安全 | 64% → 87% | 7 项 |
| 硬件 | 34% → 75% | 5 项 |
| 机器学习 | 54% → 73% | 13 项 |
| 科学 | 41% → 61% | 15 项 |
| 软件 | 43% → 56% | 20 项 |
| 媒体 | 18% → 30% | 4 项 |
| 运维 | 12% → 22% | 10 项 |
图中标注:规则手册式工作仍然处于低位。横轴:0%、25%、50%、75%、100%。
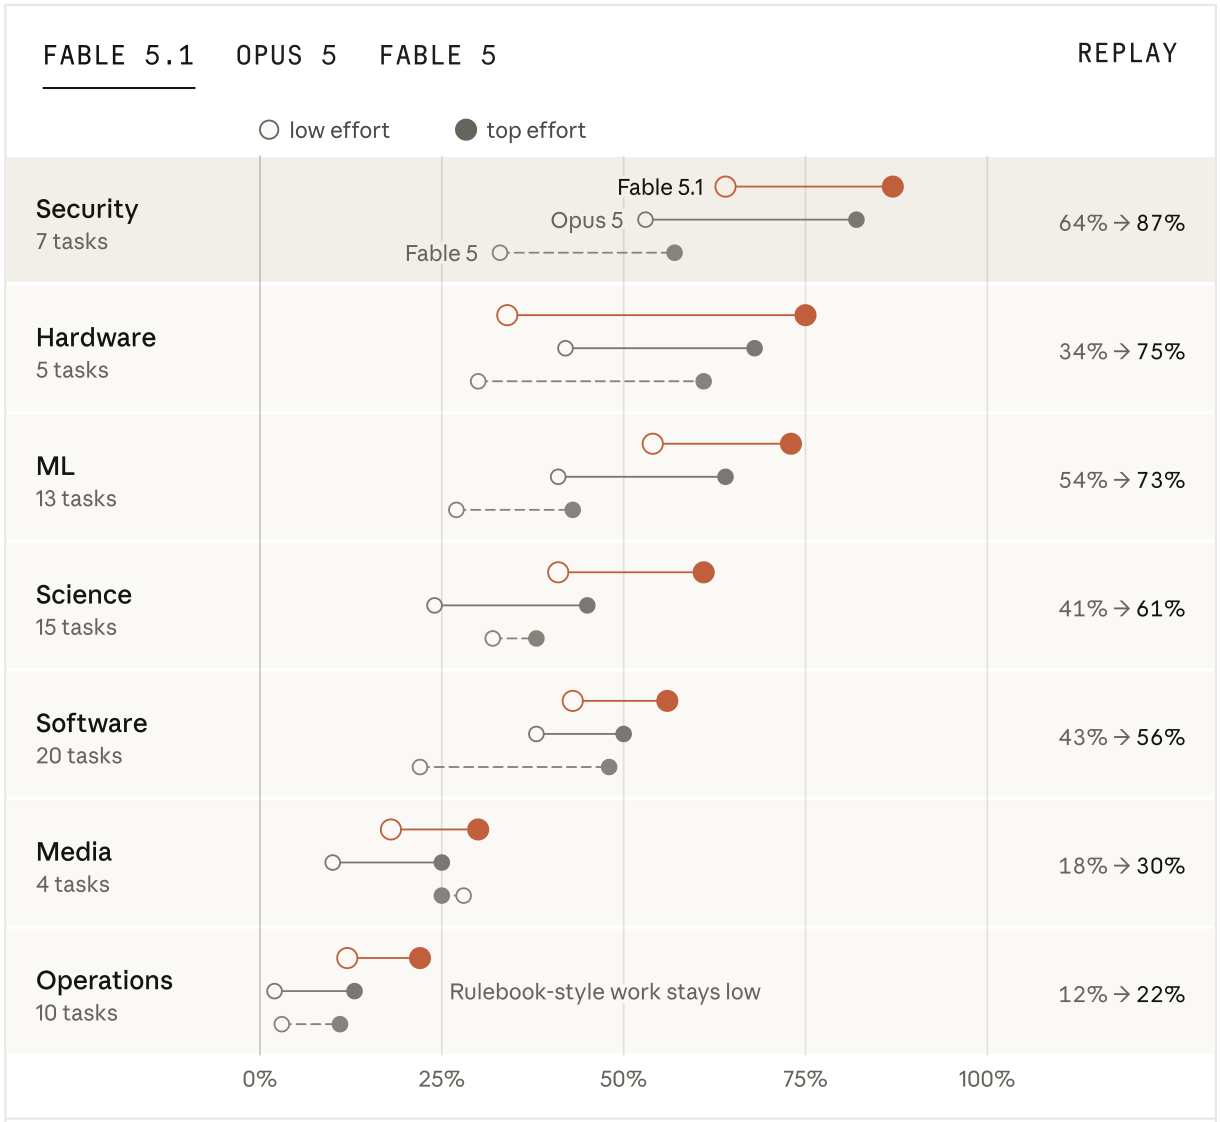
图 C 通过率。由于各类别样本较少,low effort 汇总了每个模型的两个最低档位,top effort 汇总了三个最高档位。
为了说明这一点,我从 Terminal-Bench 3.0 的不同领域选了几个问题。在这些问题中,Opus 5.5 在 low effort 下失败、在 high effort 下成功,主要是因为它进行了测试并考虑了边界情况:
-
mvcc-lsm-compaction:Terminal-Bench 3.0 的一项任务,要求根据存储引擎的崩溃报告修复 bug,同时不破坏压缩。Opus 5.5 的成绩从 low 档的 0/5 提高到了 xhigh 档的 4/5。在 low 档(每次尝试约一分钟)下,Claude 会在构建代码或运行复现程序之前就编辑代码,也没有检查新测试能否捕获原始 bug。
在 xhigh 档(约 11 分钟)下,Claude 先复现崩溃,编写随机化测试并与一个从不进行压缩的参考实现对照,然后检查自己的测试能否在修复只完成一半时失败。
-
cli-2ph-simplex:Terminal-Bench 3.0 的一项任务,要求用 Python 编写一个命令行线性规划求解器。Opus 5.5 的成绩从 low 档的 0/5 提高到了 high 档的 5/5。low 档的尝试一轮就写出求解器,用几个小问题检查后便停在约 10k token。在最后的消息中,Claude 提醒说它处理大型问题时可能会很慢,但并没有进行检查。
在 high 档的尝试中,Claude 用随机问题对照另一个暴力求解器测试自己的求解器,然后对更大的问题计时,遇到了运行时间过长或崩溃的情况,并据此重新设计了搜索过程。
-
gsea-proteomics:Terminal-Bench 3.0 的一项任务,要求对蛋白质组学数据进行基因集富集分析(GSEA),找出八种处理方法中哪些与目标组织相似。Opus 5.5 的成绩从 low 档的 0/5 提高到了 high 档的 4/5。在 low effort 下,Claude 选了一种听起来合理的数据预处理方式,用这种方式运行分析,然后报告结果。
在 high 档下,Claude 尝试了两种数据预处理方式,注意到显著处理方法的列表发生了变化,于是在选择正确方法之前深入调查了原因。
如果用户参与整个过程,Claude 可能会询问用户该如何设定问题;但在没有用户参与的情况下,high effort 表现更好。
在 Claude Code 中何时使用不同的 effort 档位
下面是我选择 effort 档位时的经验法则:
- Low: 当我希望快速响应并参与其中时使用,例如头脑风暴、画草图、简单修改。
- Medium: 适用于大多数常规软件工程工作,例如实现新功能。
- High: 适用于验证很重要或存在边界情况的工作,例如在已有代码库中修复 bug。
- Max: 当我希望 Claude 完全自主地解决困难问题时使用,例如端到端构建并验证一个应用,或在关键软件中寻找安全漏洞。
试着根据任务调整 Opus 5.5 和 Fable 5.1 的 effort,甚至可以在对话进行中使用 Claude Code 里的 /effort 来调整;然后告诉我,这是否符合你的直觉。
¹ 关于这些数字的说明:它们来自我们自己的内部运行,每项任务尝试 5 次;运行 Fable 5.1 时关闭了生产环境安全干预。在 Claude 产品中,Fable 5.1 的安全防护会将一些安全请求交给 Opus 处理。安全任务运行时也无法访问互联网,因此这里按任务统计的数量不会与公开排行榜或发布博文中的数字对应。文中的实际示例来自单次运行,其中一些使用了中间 effort 档位。